Qwen3.8-27B量化Q4_K_M+q4_0 KV llama.cpp 部署优化实战
本文是部署手册 + 调优记录,坑都埋在它出现的位置。llama.cpp 是我们的备选/回退引擎(主力为 vLLM),优势:GGUF 生态、显存弹性(Q4_K_M 权重仅 ~16GB)。
Unsloth 官方top 1%权重: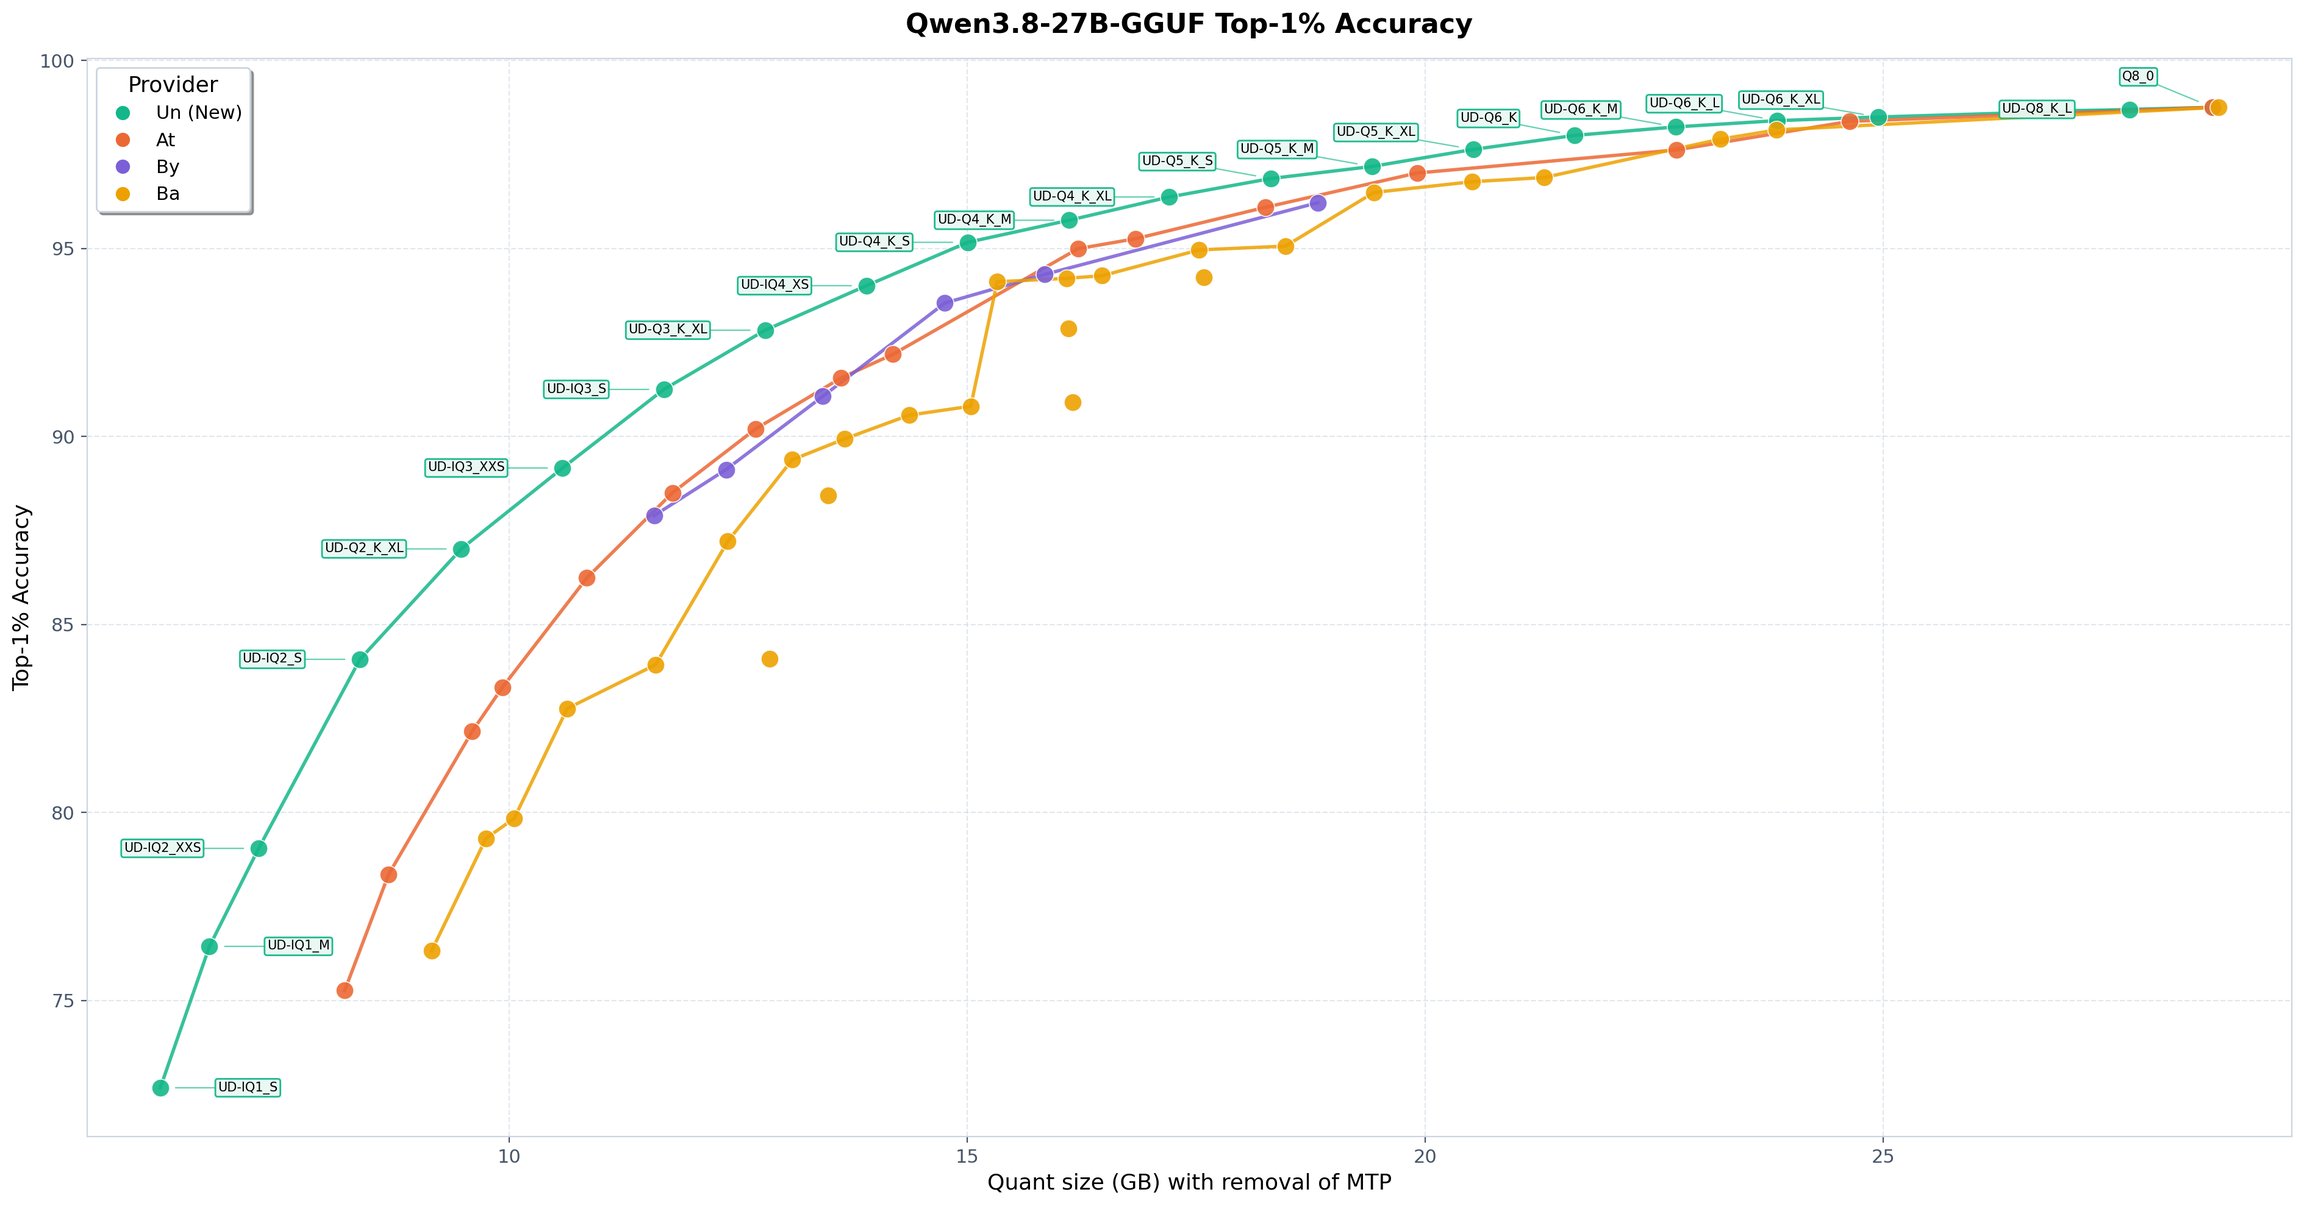
〇、运行环境
| 项 | 值 |
|---|---|
| GPU | NVIDIA RTX 6000 Ada 48GB × 1(SM89,单卡)连接方式:Riser 卡 PCIE3.0×8 |
| CPU | Intel Xeon Silver 4114 @ 2.20GHz × 2(共 20 核 40 线程,NUMA ×2) |
| 内存 | 737GB |
| OS | 麒麟 Kylin V10 SP3(x86_64,内核 4.19,笑死这系统是很多坑的来源) |
| 驱动 | NVIDIA 580.65.06(.run 安装,勿与 RPM 混装) |
| 容器 | Docker + nvidia-container-toolkit;镜像 ghcr.io/ggml-org/llama.cpp:server-cuda(b10499) |
| 网络 | 无外网、无 PyPI、镜像/模型全部离线导入 |
| 同机负载 | OCR 平台(Docker Swarm,部署前需缩容释放显存) |
核心矛盾与 vLLM 侧相同(48GB 装 27B + 百万 token KV 池 + 多路并发),但解题思路相反:vLLM 靠 FP8 权重省显存,llama.cpp 靠 int4 级权重(Q4_K_M ~16GB)把显存让给 KV 池。
一、物料清单
| 文件 | 大小 | 说明 |
|---|---|---|
Qwen3.8-27B-Q4_K_M.gguf |
~16GB | 主模型(MTP 头已内嵌 blk.64.nextn.* 张量,无需独立 MTP-Head 文件) |
mmproj-F16.gguf |
~1GB | 视觉 ViT 投影(图片输入必需) |
llama-server-cuda.tar |
— | llama.cpp server-cuda b10499 镜像 |
deploy_llama.sh |
~8KB | 一键部署脚本(本文所有参数的最终载体) |
api_keys.txt |
— | API key 文件(每行一个 key,必须与脚本同目录) |
二、部署步骤
1. 环境确认
nvidia-smi                     # 应显示 RTX 6000 Ada 48GB,驱动 >= 580
docker info | grep -i runtime  # 应含 nvidia
驱动、Docker Swarm 显存释放与 vLLM 侧完全相同(不重复,见 vLLM 篇)。Q4_K_M 三档显存需求 ~42-43GB,需空闲显存 ≥ 43GB。
2. 一键部署
chmod +x deploy_llama.sh
sudo bash deploy_llama.sh        # 默认档位 2;可选 1|2|3
固定三档(不支持任意并发/上下文组合——显存是硬约束,排列组合试出来的三档):
| 档位 | 配置 | KV 总池 | 显存(KV q4_0,25.4KB/token) |
|---|---|---|---|
| 1 | 8 并发 × 128K | 1,048,576 tok | ~43GB |
| 2 | 5 并发 × 200K | 1,024,000 tok | ~42GB |
| 3 | 4 并发 × 262K | 1,048,576 tok | ~43GB |
显存分账(三档 KV 总池均 ~104 万 tok,分账基本一致):
| 项 | 占用 | 占比 |
|---|---|---|
Q4_K_M 权重(-ngl 99 全量上卡) |
~16GB | ~37% |
| KV 池(q4_0 × 1,048,576 tok) | ~26.6GB | ~62% |
| 激活 / mmproj / CUDA 开销 | ~1GB | ~2% |
对比 vLLM 侧:FP8 权重占掉 63%,KV 池只有 ~30%。llama.cpp 的"int4 级权重 + 大 KV 池"正是靠权重省显存换来的——同一张卡,两种相反的预算分配哲学。
脚本自动执行:检查 GPU → 导入镜像 → 拷贝模型 → 停旧容器 → 启动(端口只绑 127.0.0.1)。
3. 启动参数(全部在脚本内)
| 参数 | 值 | 说明 |
|---|---|---|
| MTP 投机解码 | 开(DRAFT_N=3) |
单流 +21%;并发 ≥5 自动禁用(未实测档位的保护阈值,MTP_FORCE=1 可强开) |
REASONING_EFFORT |
medium | 默认思考强度(minimal/low/medium/high/xhigh/max) |
N_PREDICT |
16384 | 服务器 max_tokens 兜底,见下方坑 |
-ctk/-ctv |
q4_0 | KV 量化 4bit,25.4KB/tok,百万 token 池能装进 43GB 的关键 |
--kv-unified |
并发 ≥2 自动开 | 统一 KV 池,槽位按需分配而非均分 |
N_BATCH / N_UBATCH |
4096 / 512 | prefill 批大小;ubatch 调小=多并发各流更平滑 |
CACHE_REUSE / CACHE_RAM |
4096 / 65536MiB | KV shifting 复用块 / RAM prompt cache 上限 |
REASONING_FORMAT |
deepseek | 思考输出到 reasoning_content 字段(注意与 vLLM 的 reasoning 不同) |
--security-opt seccomp=unconfined |
— | 麒麟 4.19 必需:老内核 + 老 Docker 的 seccomp 拦截 clone3,容器内刷 pthread_create failed: Operation not permitted。刚需,不是可选项 |
坑:幽灵请求。b10454 时代子 agent 完成后无限生成——客户端忘了传 max_tokens,服务器也没有兜底,模型一路写到上下文耗尽。
N_PREDICT=16384(思考+正文合计)是服务器侧的最后防线,客户端显式传值优先。
坑:字段名分裂。llama.cpp 思考输出是
reasoning_content,vLLM 0.27.1 是reasoning——切换引擎时客户端(如 opencode 的interleaved配置)要对应改,否则"思考不显示"。另外 llama.cpp 侧不传 max_tokens 有 16384 兜底,vLLM 侧没有(生成至 EOS),跨引擎的客户端配置要留意这个差异。
4. 验证
curl http://localhost:9090/health      # {"status":"ok"}
docker logs qwen38-llama 2>&1 | grep -E 'n_ctx_slot|kv_unified'   # 档位与统一池
docker logs qwen38-llama 2>&1 | grep -iE 'speculative|draft'      # MTP 已加载
坑:
n_ctx_slot恒显示 262144。日志显示min(总池, 262144)——总池 ≥262144 时恒显示 262144,是截断显示不是降级,别被吓到去重部署。坑:升级镜像不生效。同名镜像
docker load会跳过,升级 b 版必须FORCE_IMAGE=1,否则跑的还是旧版。
三、缓存体系
① RAM prompt cache(--cache-ram 65536 + --cache-idle-slots)
- 跨会话前缀复用:相同前缀免全量重算,命中块驻留内存,LRU 驱逐
- 思考档位切换会改 system 前缀 → 缓存失效全量重 prefill;同一会话保持档位不变
- b10454 时代的
CACHE_REUSE语义已变;旧笔记里的--flash-attn-reuse参数不存在(两个版本都没有),别从老 wiki 抄参数
坑:默认 8192MiB 太小。按 60K token 会话 ≈1.5GB 缓存算,默认只够 ~5 个会话,容量满即 LRU 驱逐,表现为"缓存保留短、命中率莫名低"。内存 737GB 充裕,直接开到 64GB(约占 8.7%),可容纳 ~40 个会话。注意 RAM cache 无时间过期概念,纯容量 LRU;重启即丢(非持久)。
② GPU KV cache(q4_0 + kvu 统一池)
-ctk q4_0 -ctv q4_0:KV 量化到 4bit,单价 25.4KB/token——三档百万 token 池装进 43GB 的关键(q8_0 精度略高,但 5×200K/4×262K 档会超显存)--kv-unified:统一池按需分配,避免均分浪费
③ 与 vLLM 缓存的哲学差异
- llama.cpp KV 池 = 部署时按档位静态分配(如 4×262K);vLLM 是动态池(fp8 下 ~300K tok 全局共享)
- llama.cpp 单槽上限 262144 tok 是 GGUF 架构硬约束;vLLM 的
MAX_LEN是配置值 - llama.cpp 没有 CPU offload——但静态大池 + 64GB RAM cache 基本覆盖同场景
四、实测性能
MTP A/B 实测(4×262K 档,1/4 并发,8 篇 800 字写作 prompt,关思考):
| 指标 | MTP=0 | MTP=3 | 变化 |
|---|---|---|---|
| 单流 decode | 43.4 t/s | 52.4 t/s(长输出稳态 52-55) | +21% |
| 4 并发人均 | 26.8 t/s | 29.9 t/s | +12% |
| 4 并发聚合 | 96.9 t/s | 104.4 t/s | +7.7% |
| TTFT | 0.6-0.9s | 0.8s | 无差异 |
单流提速低于理论值:开放式中文写作草稿接受率偏低,实际 AL≈1.3(vLLM 侧代码场景 n=3 可到 AL 2.7-3.1)。MTP 收益是内容相关的,写作场景别指望翻倍。
与 vLLM 同口径对照(短 prompt + 400-1024 tok 输出):
| 配置 | 单流 decode | 4 并发人均 | 4 并发聚合 |
|---|---|---|---|
| llama.cpp Q4_K_M + MTP=3 | 52.4 t/s | ~29.9 t/s | 104.4 t/s |
| vLLM FP8 + fp8 KV + MTP | 40-48 t/s | ~36 t/s | 75.7(APC 冷)/ 122.9 t/s(暖) |
结论:llama.cpp 赢单流与冷态 4 路;vLLM 赢长 prompt 大批次(8.4K prompt 口径聚合 136 t/s)与 APC 暖态。选型看负载形状,不是看跑分。
历史基线(b10454 → b10499 升级):5×200K 压测吞吐持平(111.2 → 108.7 t/s,波动范围),收益全在稳定性——幽灵请求消失(truncated=0)、大 prefill 期间 decode 饿死缓解(-ub 512 调度步从秒级降到 0.7s)、跨会话 RAM cache 复用、显存省 3.4GB。
五、经验清单
- GGUF 路线的价值在显存弹性:权重省下来的每一 GB 都是 KV 池——int4 权重 + 大池是 48GB 单卡跑 200K×4 的唯一解
- MTP 收益内容相关:代码/结构化场景接受率高,开放写作场景低,用 AL 不用跑分判断
- 兜底要在服务器侧:客户端不可信(忘传 max_tokens、乱传参数),
N_PREDICT这种服务器兜底能挡住一整类幽灵事故 - 缓存默认值为笔记本设计:RAM cache 默认 8GB 在服务器上就是笑话,按会话体积 × 会话数算清楚再开
- 日志显示值 ≠ 真实值(n_ctx_slot 截断显示、props 显示与启动参数不一致),改配置前先确认看到的是哪种
环境:麒麟 V10 SP3 / RTX 6000 Ada 48GB / llama.cpp server-cuda b10499 / Qwen3.8-27B Q4_K_M,2026-08。